Ce code Python pourrait vous empêcher de trop dépenser pour votre prochain ordinateur portable
Si vous envisagez un nouvel ordinateur portable, vous pourriez vous demander combien vous devriez en payer un. Vous pourriez parcourir des sites web, mais un peu de code Python et une régression linéaire pourraient faciliter le travail.
Pourquoi créer un prédicteur de prix d'ordinateur portable ?
Vous pourriez parcourir des milliers de pages et fouiller dans les magasins physiques, mais cela prendrait beaucoup de temps. J'aime les ordinateurs, mais je n'ai ni le temps ni l'envie pour cette tâche. J'ai d'autres choses que je préférerais faire. J'aimerais avoir un programme dans lequel je peux entrer des spécifications telles que la quantité de RAM que je veux ou la résolution d'écran dont j'ai besoin et qu'il me donne le prix.
Il y a tellement de machines sur le marché qu'il serait difficile pour moi de traiter toutes ces informations à la main. J'ai aussi pensé que partager ces informations avec d'autres personnes qui pourraient être à la recherche d'un nouvel ordinateur portable pourrait être utile. Qui veut payer trop cher pour une machine ? Pas moi, et je peux deviner que vous non plus.
Avec mes connaissances en régression linéaire issues des statistiques, j'ai réalisé que je pouvais facilement construire un modèle pour répondre à ces questions. Python est un excellent langage, et j'avais déjà une certaine familiarité de base avec lui. Il est devenu populaire en analyse de données car il est assez simple pour que des personnes sans formation en informatique puissent l'apprendre, tout en offrant des bibliothèques puissantes pour analyser les données.
Assembler l'ensemble d'outils statistiques Python
Pour ce projet, j'ai utilisé des éléments de l'écosystème statistique Python avec lesquels j'étais déjà à l'aise.
J'avais déjà configuré un environnement Mamba avec ces outils. Bien que de nombreux systèmes, y compris Linux, incluent Python, il est destiné à supporter le système et moins les programmes utilisateurs. Si vous mettez à jour Python du système, il se peut que les scripts qui en dépendent ne fonctionnent plus. Il existe des outils pour installer des environnements personnalisés comme VirtualEnv.
Le premier composant est NumPy. C'est une bibliothèque populaire pour toutes sortes d'opérations numériques, en particulier les calculs statistiques et d'algèbre linéaire qui se dérouleront en arrière-plan.
La prochaine bibliothèque dont vous aurez besoin est Pandas, qui vous permettra d'importer le jeu de données et de le visualiser en colonnes sous forme de « data frame ». C'est un peu comme un mélange entre une base de données relationnelle et un tableur. Vous pouvez également effectuer des manipulations puissantes sur vos données.
Seaborn est une bibliothèque pour visualiser des graphiques de données statistiques. Je l'utilise pour visualiser la distribution des données dans des histogrammes, des nuages de points et des régressions linéaires.
Enfin, Pingouin me permet de réaliser de nombreux tests statistiques facilement, sans avoir à mémoriser toutes ces formules que j'ai oubliées dans mon cours de statistiques à l'université il y a des années. C'est le programme qui construira le modèle par régression linéaire multiple du prix de détail par rapport à toutes les caractéristiques des ordinateurs portables.
Mettre tout cela en place est simple dans la plupart des environnements de type Unix, y compris Windows en utilisant le Sous-système Windows pour Linux. Vous pouvez suivre les instructions sur la page web pour l'installer.
Les notebooks Jupyter offrent un moyen relativement convivial d'exécuter des commandes Python et de voir les résultats, ainsi que de les stocker pour plus tard, mais cela reste strictement optionnel. J'ai créé un notebook Jupyter et je vais en utiliser des exemples de code pour la démonstration. Je l'ai publié sur mon GitHub, donc vous pouvez voir le code et certains exemples que je n'ai pas pu couvrir dans cet article.
Avec Mamba installé, vous pouvez créer l'environnement dont vous avez besoin. Comme dans une émission de cuisine, j'en avais déjà un prêt. Pour l'activer, je tape ceci dans le terminal Linux :
mamba activate stats
Acquisition des données de l'ordinateur portable
Pour construire le jeu de données pour le modèle de régression, je pourrais parcourir les magasins en ligne et constituer une base de données complète de laptops. Cela prendrait beaucoup de temps à mettre en place, ainsi qu'à nettoyer les données pour qu'elles soient cohérentes. Heureusement, quelqu'un l'a déjà fait.
Il existe une base de données d'ordinateurs portables avec certaines spécifications matérielles telles que la vitesse du processeur, la quantité de RAM, la capacité de stockage et les résolutions d'écran horizontale et verticale disponibles sur Kaggle.
Le prix des ordinateurs portables était en euros, mais une vérification rapide sur Xe.com en juillet 2025 a montré que le taux de change entre l'euro et le dollar américain est assez proche.
Construction du modèle de régression
Avec l'environnement en place et les données acquises, il est maintenant temps de construire le modèle. Tout d'abord, je dois importer les bibliothèques que je vais utiliser.
import numpy as np
import pandas as pd
import seaborn as sns
%matplotlib inline
import pingouin as pg
Ces lignes importent les bibliothèques NumPy, Pandas, Seaborn et Pingouin. Numpy, Pandas, Seaborn et Pingouin sont abrégés en « np, pd, sns et pg ». La ligne qui commence par « % » est destinée à une utilisation dans les notebooks Jupyter. Elle indique d'utiliser la bibliothèque Matplotlib qui dessine les graphiques pour les afficher directement dans le notebook Jupyter. Sinon, ils seront affichés dans une fenêtre séparée.
Ensuite, nous importerons les données avec Pandas :
laptops = pd.read_csv("data/laptop_prices.csv")
Cela va créer un DataFrame Pandas. Nous pouvons voir comment les données sont disposées avec la méthode head() :
laptops.head()
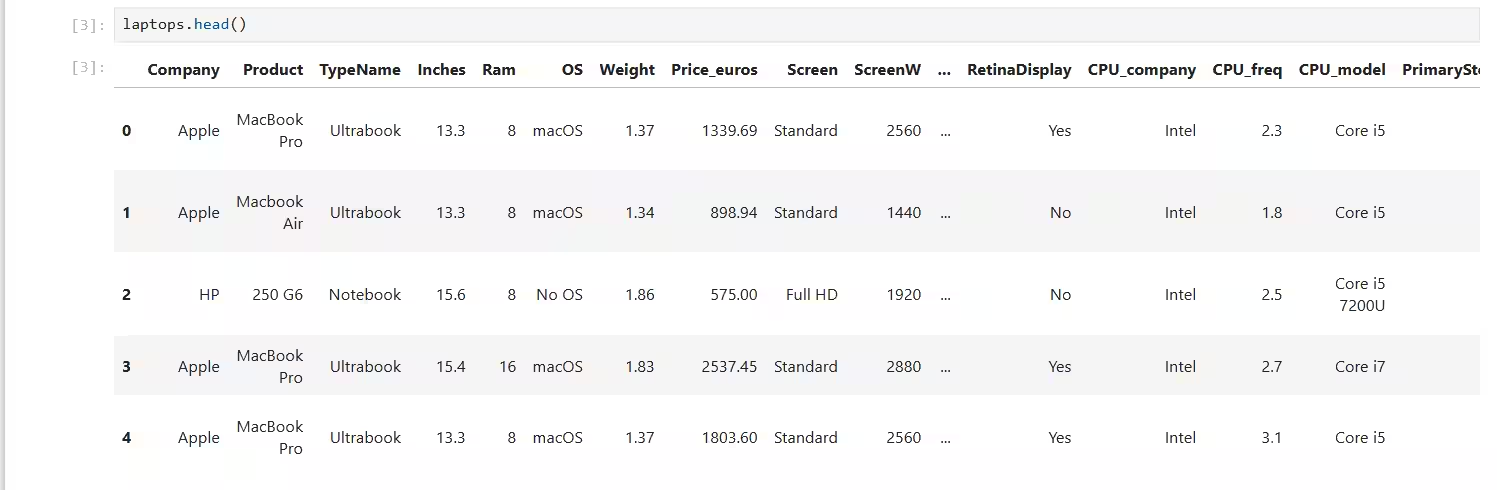
Nous pouvons également voir des statistiques descriptives de base de toutes les colonnes numériques avec la méthode describe().
laptops.describe()
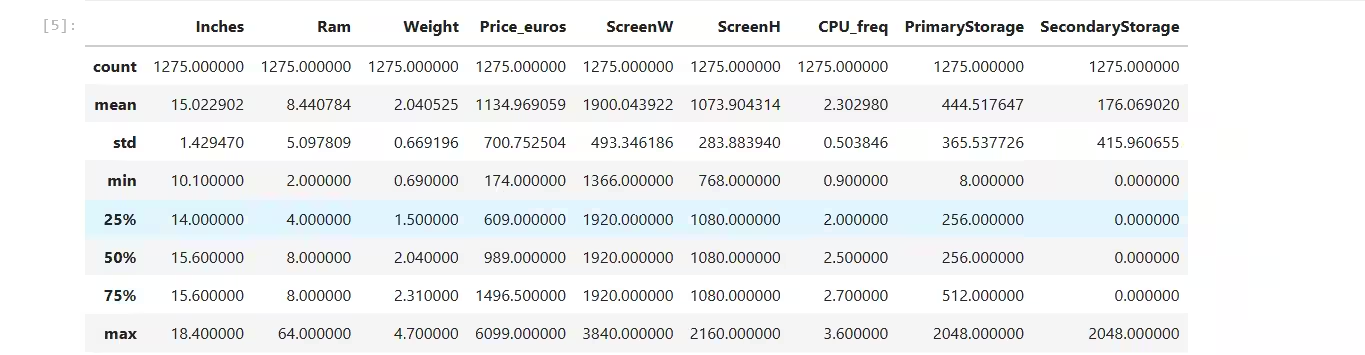
Cela affichera la moyenne, la médiane, l'écart type, la valeur minimale, le quartile inférieur ou 25e percentile, la médiane, le quartile supérieur ou 75e percentile, et la valeur maximale de chaque colonne.
J'aime aussi visualiser les distributions de données à travers des histogrammes. Le displot de Seaborn le fait.
Pour voir comment les prix sont répartis :
sns.displot(x='Price_euros',data=laptops)
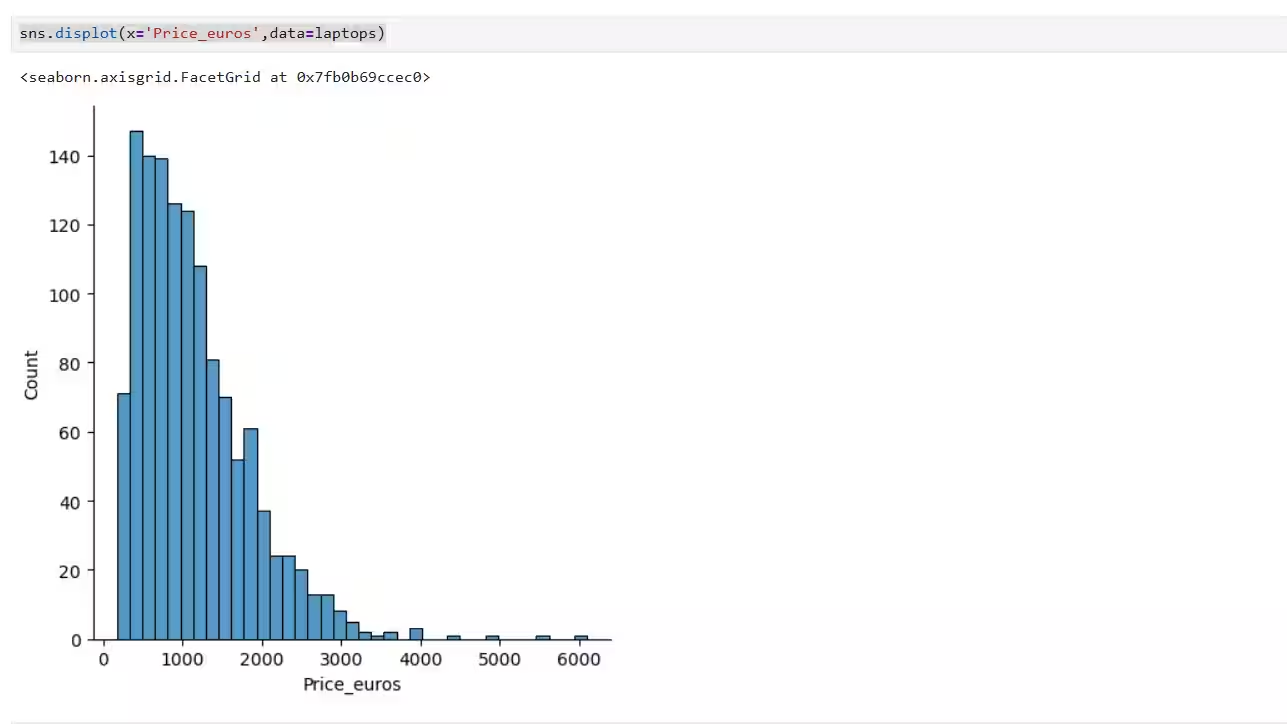
Cela indique à Pingouin de tracer les prix le long de l'axe des x et d'utiliser le dataframe laptop comme source. La queue de la distribution est visiblement décalée vers la droite.
Nous allons construire un modèle qui utilise différentes spécifications. Il ressemblera à quelque chose comme ceci :
prix=a(vitesse du CPU) + b(RAM) + c(taille en pouces) ...
Les lettres représentent les coefficients définis par la régression. C'est similaire à la régression linéaire simple que vous avez peut-être vue, mais au lieu d'ajuster une ligne sur un nuage de points, vous ajustez un plan. Comme il y a plus de trois dimensions dans ce modèle, il s'agit en réalité d'un hyperplan.
Pour obtenir la régression du prix en euros par rapport à la taille de l'ordinateur portable, la vitesse du processeur, la taille de l'écran, le poids, le stockage principal et le stockage secondaire, utilisez la fonction de régression linéaire de Pingouin :
pg.linear_regression(laptops[['Inches','Ram','Weight','ScreenW','ScreenH','CPU_freq','PrimaryStorage','SecondaryStorage']],laptops['Price_euros'],relimp=True)
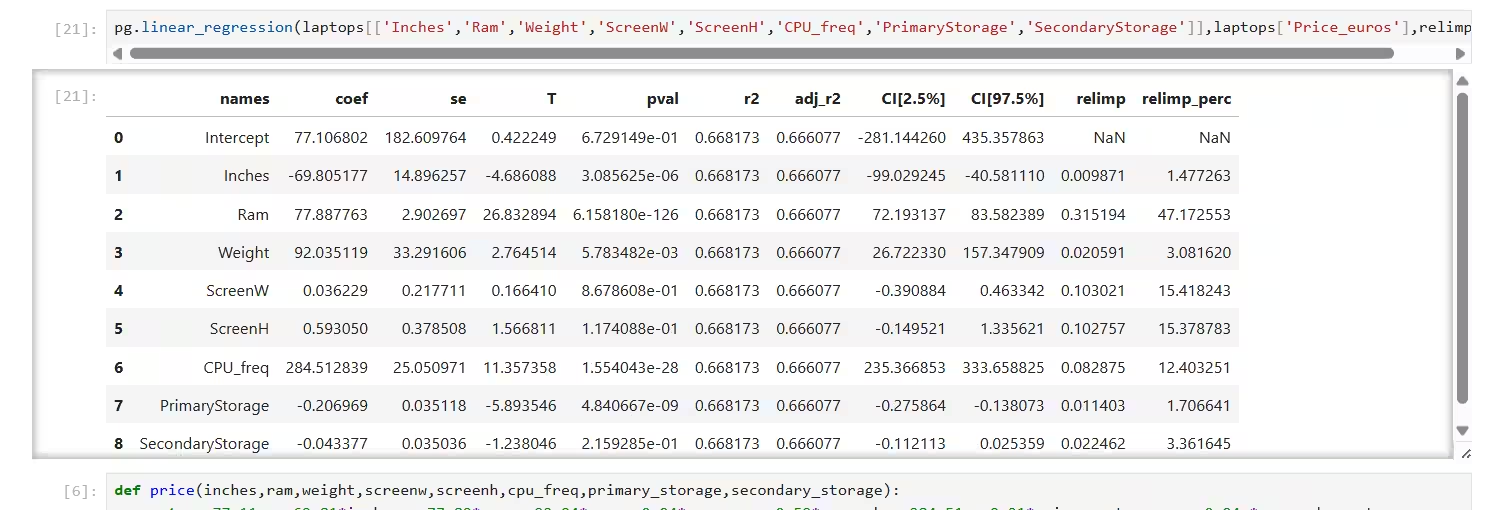
Cela nous donnera les coefficients pour cette équation de régression. L'option relimp= indiquera à Pingouin de calculer combien chaque variable contribue au prix. Les coefficients seront affichés dans la colonne la plus à gauche, la colonne tout à droite nous indiquant que la RAM est le meilleur prédicteur du prix. Le chiffre à prendre en compte pour déterminer la qualité de l'ajustement est le carré du coefficient de corrélation, qui est « r2 » dans ce tableau. Il est d'environ 0,66, ce qui signifie que l'ajustement est assez bon.
Avec les coefficients prédits, nous pouvons maintenant insérer des valeurs dans l'équation pour prédire le prix. Voici une fonction qui fait exactement cela :
def price(inches,ram,weight,screenw,screenh,cpu_freq,primary_storage,secondary_storage):
return 77.11 + -69.81*inches + 77.89*ram + 92.04*ram + 0.04*screenw + 0.59*screenh + 284.51 - 0.21*primary_storage + -0.04 * secondary_storage
Vous devriez indenter la deuxième ligne, mais les limites de notre système m'obligent à la présenter ainsi.
Les prix varient-ils vraiment selon les marques ?
Ce modèle de régression ne prend en compte que les spécifications. Vous pourriez vous demander si le prix est vraiment un prédicteur du prix. Nous pouvons utiliser l'analyse de variance, ou ANOVA, pour déterminer si les différences entre les marques sont significatives. Comme les données de prix étaient asymétriques, comme le montre l'histogramme, un test non paramétrique sera plus précis. Pingouin propose un test de Kruskal-Wallis qui effectue cela.
Cela testera l'hypothèse nulle selon laquelle il n'y a pas de relation entre le prix et la marque :
pg.kruskal(data=laptops,dv='Price_euros',between='Company').round(2)

La valeur p est de 0, ce qui signifie que ce prix est effectivement significatif. L'arrondissement a été fait pour rendre la valeur p plus évidente. Sinon, elle serait affichée en notation scientifique. Cela signifie que nous pouvons rejeter l'hypothèse nulle et conclure que la marque est un prédicteur du prix.
J'ai pu créer un prédicteur de prix pour m'aider à déterminer quel serait un prix juste à payer pour une machine en fonction de ses spécifications, et un autre pour déterminer l'importance de la marque. Cela montre la puissance de Python et de ses bibliothèques pour rendre quelque chose qui aurait pu être difficile à faire à la main réalisable en quelques lignes de code.