Guide du débutant en Python pour le traitement des données
Python est un langage polyvalent populaire, mais il est de plus en plus privilégié pour les statistiques, l'analyse de données et la science des données. Si vous avez une connaissance de base des statistiques, comment pouvez-vous l'appliquer à Python ? Voici comment commencer à filtrer les données avec Python plus rapidement que vous ne pourriez jamais le faire à la main.
Pourquoi Python pour les données ?
Bien que Python soit populaire pour l'analyse de données, vous pourriez vous demander pourquoi vous voudriez utiliser Python au lieu d'un tableur comme Excel, LibreOffice Calc ou Google Sheets.
La principale raison d'utiliser Python est que vous disposez de beaucoup plus d'options que celles incluses dans la plupart des tableurs. Les tableurs sont principalement conçus pour les calculs commerciaux et financiers. Vous pouvez effectuer des calculs plus avancés avec Python, car vous pouvez exploiter le grand nombre de bibliothèques de Python.

L'autre problème est la scalabilité. Les feuilles de calcul fonctionnent mieux avec de petits ensembles de données, bien que les utilisateurs intensifs puissent créer des monstres de plusieurs centaines de lignes. Pour effectuer des opérations, il faut cliquer et faire glisser les colonnes vers le bas. Cela fonctionne pour quelques lignes, mais si vous avez plusieurs écrans de données, vos doigts peuvent rapidement se fatiguer.
Les opérations de données en Python, avec des bibliothèques comme NumPy, pandas, Seaborn et Pingouin, sont beaucoup plus efficaces lorsqu'on travaille avec de grandes quantités de données. Vous pouvez spécifier des opérations complexes, comme sélectionner des données de plusieurs colonnes et effectuer des calculs dessus, en une ou quelques lignes. Mieux encore, vous pouvez écrire des scripts pour automatiser ces opérations afin de n'avoir à les taper qu'une seule fois au départ.
Les tableurs ont toujours leur place. Ils sont parfaits pour des opérations rapides, ainsi que pour la mise en forme des données à utiliser en Python. Je vais même vous montrer comment importer des données à partir de tableurs. Pour la mise en forme des données, si vous devez que les données respectent des contraintes comme la longueur des caractères ou un type de nombre comme un entier, un petit système de gestion de base de données comme SQLite est encore mieux.
Pour être concis, cet article couvrira l'utilisation des bibliothèques Python pour des calculs statistiques de base et n'expliquera pas beaucoup la théorie. Si vous souhaitez en savoir plus sur la théorie statistique, il existe de nombreuses ressources en ligne et hors ligne, y compris des cours, des manuels et des vidéos. Vous pouvez essayer le manuel en ligne d'OpenStax ou Khan Academy pour des options d'apprentissage gratuites.
Configurer votre environnement
Pour configurer votre environnement pour l'analyse des données, vous devrez installer certaines bibliothèques mentionnées précédemment. Je suppose que vous utilisez un système de type Unix, comme Linux, macOS, ou Windows avec le Sous-système Windows pour Linux installé.
La première chose que vous devrez installer est Mamba, qui est un gestionnaire de paquets pour ces bibliothèques. La plupart des systèmes Linux sont livrés avec un gestionnaire de paquets, alors pourquoi auriez-vous besoin d'un gestionnaire de paquets en plus de votre gestionnaire de paquets ? Les gestionnaires de paquets du système contiennent Python et les bibliothèques que je mentionne, mais ils sont principalement destinés à gérer le système d'exploitation lui-même, et non vos projets de programmation. Les développeurs ont tendance à vouloir des versions plus récentes que celles fournies avec la plupart des distributions grand public, ce qui explique pourquoi les distributions à publication continue sont populaires parmi ce groupe. Mamba offre une troisième option, vous permettant d'exécuter un système de base stable tout en offrant l'accès à des paquets de développement plus récents. Vous pouvez suivre les instructions sur le site web. En résumé, il s'agit de coller un script dans votre terminal.
Avec Mamba installé, vous devrez installer les bibliothèques. Les bibliothèques que nous utiliserons dans cet article sont NumPy, pandas, SciPy et Pingouin. Nous installerons également IPython, car il est très pratique pour une utilisation interactive par rapport à l'interpréteur Python standard.
Nous allons créer un environnement appelé « stats » avec Mamba avec ces packages.
mamba create -n stats
Alors nous devrons l'activer.
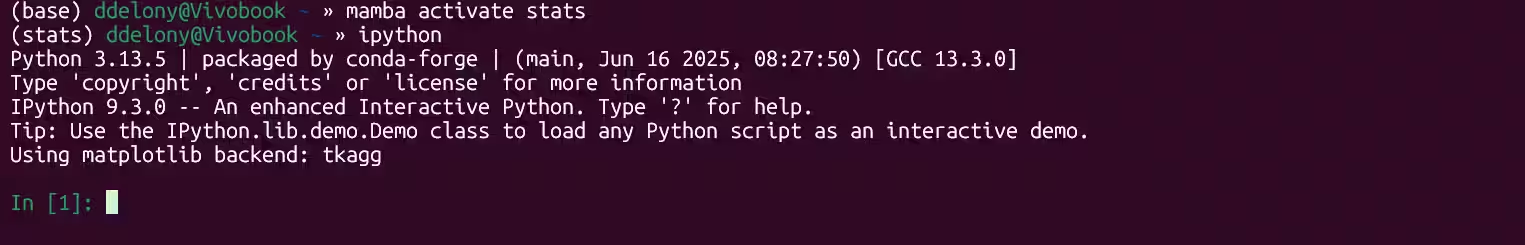
mamba activate stats
Une fois notre environnement créé, nous pouvons ensuite installer des packages.
mamba install ipython numpy pandas scipy seaborn pingouin
Maintenant que l'environnement est prêt, nous pouvons commencer les calculs.
Obtention des données
Pour effectuer des calculs statistiques, vous aurez besoin de certaines données. Il peut s'agir de données que vous possédez déjà, telles qu'une feuille de calcul. Cela pourrait être des données que vous avez téléchargées depuis un site comme Kaggle. Seaborn et Pingouin peuvent accéder à des ensembles de données publics pour que vous puissiez les explorer et en tirer des enseignements.
Pour commencer, assurez-vous que votre environnement "stats" est actif, puis lancez IPython :
ipythonNous commencerons par importer pandas :
import pandas as pd
Pandas dispose de méthodes pour lire à partir des formats de fichiers de données populaires, y compris Excel .xls et le format de valeurs séparées par des virgules ou .csv, qui est répandu en analyse de données.
Nous allons utiliser la méthode read_csv de pandas pour lire un fichier. Je vais démontrer cela avec mes données sur le prix des ordinateurs portables que j'ai utilisées pour créer un modèle complexe récemment.
data = pd.read_csv("data/laptop_prices.csv")
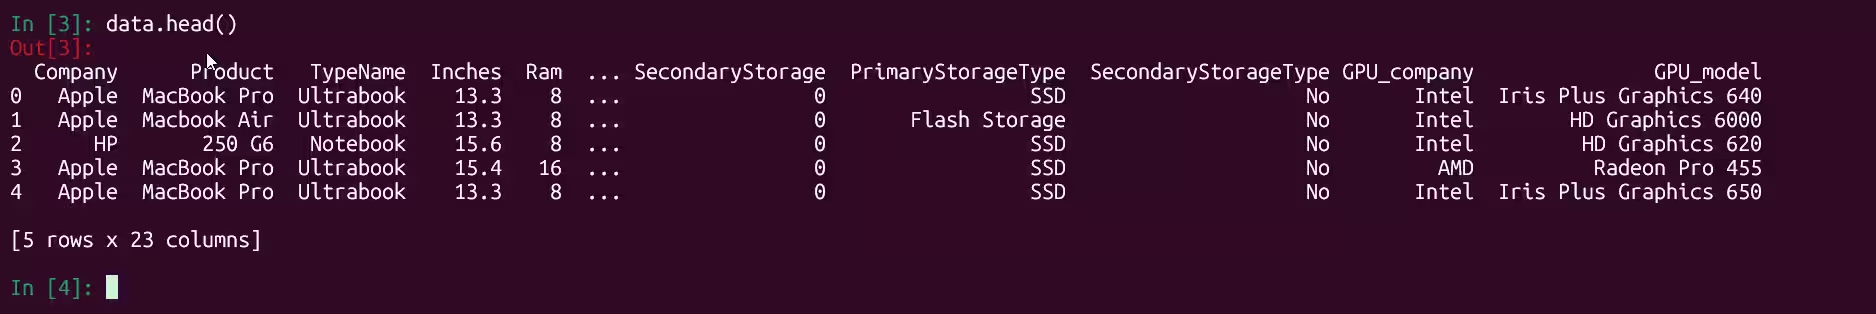
Cela créera une structure de données appelée « DataFrame », qui est similaire à une feuille de calcul ou à une base de données relationnelle. Considérez-la comme un tableau contenant les données. Vous pouvez voir les premières lignes en appelant la méthode head sur le DataFrame :
data.head()
Vous pouvez également créer des données vous-même en les générant aléatoirement. Cela est utile pour créer des données de test. Vous pouvez utiliser le générateur de nombres aléatoires de NumPy pour cela.
Tout d'abord, importez NumPy :
import numpy as np
Ensuite, nous allons créer un générateur de nombres aléatoires :
rng = np.random.default_rng()
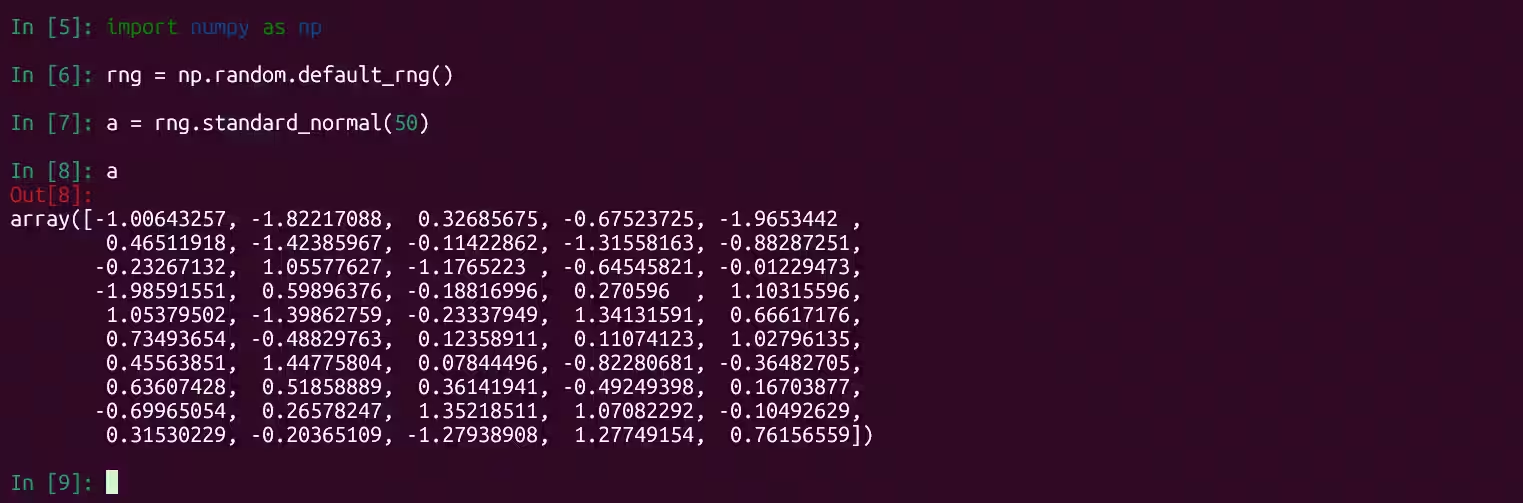
Nous pouvons créer un tableau de 50 nombres aléatoires tirés de la distribution normale :
a = rng.standard_normal(50)
Statistiques descriptives : moyenne, médiane, écart type, percentiles
Il est facile de calculer des statistiques descriptives de base en utilisant Python et pandas.
Nous allons utiliser le jeu de données tips de Seaborn pour notre DataFrame :
import seaborn as sns
tips = sns.load_dataset('tips')

Pour voir les colonnes, utilisez la méthode head() mentionnée ci-dessus.
tips.head()

Nous pouvons utiliser la méthode describe pour obtenir des statistiques descriptives de toutes les colonnes numériques du DataFrame.
tips.describe()
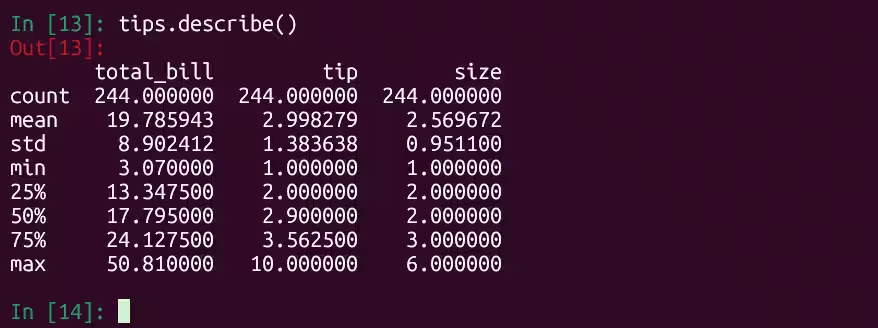
Pandas affichera les données pour les colonnes « total_bill », « tip » et « size ». Cela inclura le nombre de points de données, la moyenne, l'écart type, la valeur minimale, le quartile inférieur ou 25e percentile, la médiane ou 50e percentile, et le quartile supérieur ou 75e percentile.
Vous pouvez également consulter les statistiques descriptives d'une colonne individuelle :
tips['total_'bill'].describe()

Vous pouvez également consulter les statistiques d'une colonne. Par exemple, pour voir le pourboire médian :
tips['tip'].median()

Régression : Quelle est la tendance ?
Les statistiques descriptives permettent de donner des descriptions des données. La puissance de l'analyse des données provient de la découverte des relations dans les données. La régression linéaire est l'une des façons les plus simples de le faire.
Nous pouvons visualiser la régression linéaire comme l'ajustement d'une ligne sur des points de données.
Revenons à notre jeu de données sur les pourboires. Nous allons utiliser Seaborn pour tracer les pourboires en fonction du total de la facture. Le montant de la facture, la variable indépendante, sera sur l'axe des x, et le pourboire, la variable dépendante, sera sur l'axe des y. Nous pouvons tracer la ligne de régression sur le nuage de points pour voir à quel point l'ajustement est bon.
sns.regplot(x='total_bill',y='tip',data=tips)

Nous pouvons également obtenir une analyse plus formelle avec Pingouin :
import pingouin as pg
pg.linear_regression(tips['total_bill'],tips['tip'])
La colonne la plus à gauche contiendra l'ordonnée à l'origine et le coefficient pour la valeur de x, dans ce cas, le montant total de la facture. Cela vous permettra de reconstruire la droite sous forme d'équation de la droite avec pente-interception standard, mais le chiffre auquel il faut faire attention est le carré du coefficient de corrélation, ou r². Dans ce cas, il est d'environ 0,46, ce qui correspond assez bien dans la direction positive, confirmant ce que nous avons observé dans le graphique.
Tests statistiques : les différences ont-elles vraiment de l'importance ?
Une chose qui revient souvent dans les expériences comportant un groupe témoin et un groupe expérimental, comme un essai clinique d’un nouveau médicament, est de déterminer si les différences entre les deux sont dues au hasard ou non. Les tests statistiques entre les groupes peuvent nous aider à déterminer si une différence est statistiquement significative ou non.
L'un des tests les plus populaires dans la recherche contemporaine est le test t de Student, car il est efficace pour traiter les petits échantillons nécessaires dans les expériences.
Nous allons utiliser le générateur de nombres aléatoires de NumPy pour créer quelques groupes simulés de dix éléments chacun :
import numpy as np
rng = np.random.default_rng()
a = rng.standard_normal(10) * 20
b = rng.standard_normal(10) * 50
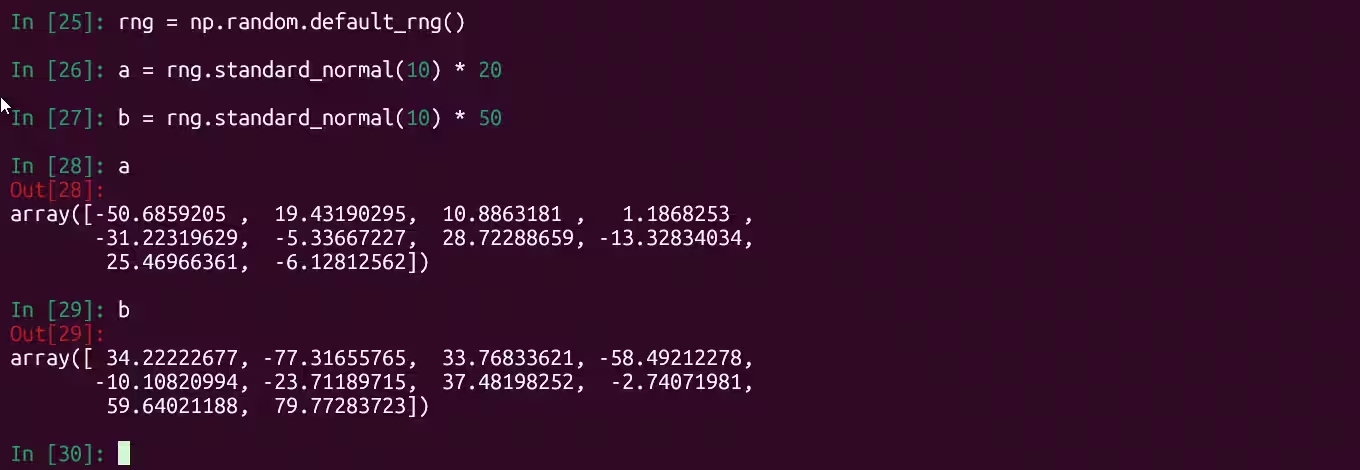
Pingouin dispose d'une fonction de test t intégrée pour tester l'hypothèse nulle selon laquelle il n'y a pas de différence significative entre les deux groupes :
pg.ttest(a,b)

Le nombre permettant de déterminer la signification dans le résultat est la valeur p. Nous utiliserons une valeur p de 0,05 pour déterminer la signification. Le résultat est d'environ 0,61. Comme cela est supérieur à 0,05, nous ne pouvons pas rejeter l'hypothèse nulle, donc nous concluons que les résultats ne sont pas statistiquement significatifs.
Ces exemples ne font qu'effleurer la surface en matière d'analyse de données avec Python. Maintenant que vous avez vu à quel point les opérations de données en Python peuvent être simples et puissantes grâce à l'aide de ces bibliothèques, vous comprenez pourquoi Python est un langage de prédilection pour l'analyse de données et la science des données.