Régression en Python : Comment trouver des relations dans vos données
Se contenter de collecter des données ne suffit pas. Vous pouvez remplir des tableaux avec des données, mais cela reste inutile si vous ne pouvez pas agir en conséquence. La régression est l'un des outils statistiques les plus puissants pour trouver des relations dans les données. Python le rend facile et il est beaucoup plus flexible qu'un tableur. Posez ce crayon et cette règle et prenez Python à la place. Voici comment commencer.
Régression Linéaire Simple : Identifier les Tendances
La forme la plus simple de régression en Python est, eh bien, la régression linéaire simple. Avec la régression linéaire simple, vous essayez de voir s'il existe une relation entre deux variables, la première étant connue sous le nom de « variable indépendante » et la seconde sous le nom de « variable dépendante ». La variable indépendante est généralement représentée sur l'axe des x et la variable dépendante sur l'axe des y. Cela crée le nuage de points classique des données. L'objectif est de tracer une ligne qui correspond le mieux à ce nuage de points.
Nous commencerons par utiliser les données d'exemple sur les pourboires dans les restaurants de New York. Nous voulons voir s'il existe une relation entre le montant total de l'addition et le pourboire. Cet ensemble de données est inclus dans le package de visualisation statistique Seaborn, mon outil de visualisation de données préféré. J'ai configuré ces outils dans un environnement Mamba pour un accès facile.
Tout d'abord, nous importerons Seaborn, une bibliothèque de traçage statistique.
import seaborn as sns
Ensuite, nous chargerons le jeu de données :
tips = sns.load_dataset('tips')
Si vous utilisez un notebook Jupyter, comme celui auquel je fais référence sur ma propre page GitHub, assurez-vous d'inclure cette ligne pour afficher les images dans le notebook plutôt que dans une fenêtre externe :
%matplotlib inline
Nous allons maintenant examiner le nuage de points avec la méthode relplot :
sns.relplot(x='total_bill',y='tip',data=tips)

Le nuage de points semble être principalement linéaire. Cela signifie qu'il pourrait y avoir une relation linéaire positive entre le montant de la facture et le pourboire. Nous pouvons tracer la ligne de régression avec la méthode regplot :
sns.regplot(x='total_bill',y='tip',data=tips)

La ligne semble s'adapter assez bien.
Nous pouvons utiliser une autre bibliothèque, Pingouin, pour une analyse plus formelle. La méthode linear_regression de Pingouin calculera les coefficients de l'équation de régression de la ligne afin de s'adapter aux points de données et de déterminer la qualité de l'ajustement.
import pingouin as pg
pg.linear_regression(tips['total_bill'],tips['tip']).round(2)

L'arrondi facilitera la lecture des résultats. Le nombre auquel il faut prêter attention en régression linéaire est le coefficient de corrélation. Dans le tableau résultant, il est indiqué comme "r2" car il s'agit du carré du coefficient de corrélation. Il est de 0,46, ce qui indique un bon ajustement. En prenant la racine carrée, on obtient environ 0,68, ce qui est assez proche de 1, indiquant une relation linéaire positive de manière plus formelle que le graphique que nous avons vu précédemment.
Nous pouvons également construire un modèle avec les valeurs du tableau. Vous vous souvenez peut-être de l'équation d'une droite : y=mx + b. Le y serait la variable dépendante, le m est le coefficient de x, ou le total de la facture, qui est de 0,11. Cela détermine la pente de la droite. Le b est l'ordonnée à l'origine, ou 0,92.
L'équation résultante basée sur ce modèle est
tip = 0.11(total bill) + 0.92
Les équations pour la régression inversent cela, donc ce serait :
tip = 0.92 + 0.11(total_bill)
Nous pouvons écrire une courte fonction Python qui prédit le pourboire en fonction du montant de l'addition.
def tip(total_bill):
return 0.92 + 0.11 * total_bill
La deuxième ligne est censée être indentée, mais notre CMS ne peut pas l'afficher, alors veuillez vous assurer d'indenter cette ligne sur votre machine. N'oubliez pas que les indentations en Python font quatre espaces.
Prédictions du pourboire pour une note de restaurant de 100 $ :
tip(100)
Le pourboire attendu est d’environ 12 $.
Régression Linéaire Multiple : Emporter la Régression dans la Troisième Dimension, et Au-Delà
La régression linéaire peut être étendue à plus de deux variables. Vous pouvez examiner davantage de variables indépendantes. Au lieu d'ajuster une ligne aux points de données sur un plan, vous ajustez un plan sur un nuage de points. Malheureusement, cela est plus difficile à visualiser qu'avec une régression en 2D. J'ai utilisé la régression multiple pour construire un modèle des prix des ordinateurs portables en fonction de leurs caractéristiques.
Nous allons utiliser le jeu de données des pourboires. Cette fois, nous allons examiner la taille du groupe avec la colonne « size ». C'est facile à faire avec Pingouin.
pg.linear_regression(tips[['total_bill','size']],tips['tip']).round(2)
Remarquez les doubles crochets sur le premier argument spécifiant la facture totale et la taille du groupe. Notez que le r² est identique. Cela signifie encore une fois qu'il y a un bon ajustement et que la facture totale et la taille de la table sont de bons prédicteurs du pourboire.
Nous pouvons réécrire notre modèle précédent pour tenir compte de la taille, en utilisant le coefficient de la taille de la table :
def tip(total_bill,size):
return 0.67 + 0.09 * total_bill + 0.19 * size
Régression non linéaire : Ajustement de courbes
Non seulement vous pouvez ajuster une régression linéaire, mais vous pouvez également ajuster des courbes non linéaires. Je vais démontrer cela en utilisant NumPy pour générer quelques points de données pouvant représenter un graphique quadratique.
Tout d'abord, je vais générer un grand tableau de points de données dans NumPy pour l'axe des x :
x = np.linspace(-100,100,1000)
Maintenant, je vais créer un graphique quadratique pour l'axe des y.
y = 4*x**2 + 2*x + 3
Pour créer la régression, je vais construire un DataFrame Pandas, une structure de données similaire à une base de données relationnelle, pour les axes x et y. Cela créera des colonnes pour les valeurs x et y, avec les noms "x" et "y". Nous passons un dictionnaire pour le DataFrame que nous voulons créer à Pandas. Nous appellerons ce DataFrame "df".
import pandas as pd
df = pd.DataFrame({'x':x,'y':y})
Nous pouvons examiner notre DataFrame avec la méthode head :
df.head()

Nous pouvons créer un nuage de points avec Seaborn comme nous l'avons fait précédemment avec les données linéaires :
sns.relplot(x='x',y='y',data=df)

Cela ressemble à la courbe parabolique classique que vous pourriez vous rappeler de votre cours de mathématiques, tracée sur votre calculatrice graphique (que Python peut remplacer). Voyons si nous pouvons y ajuster une parabole. La méthode regplot de Seaborn dispose de l'option order, qui spécifie le degré du polynôme à ajuster. Comme nous essayons de tracer une courbe quadratique, nous allons régler order sur 2 :
sns.regplot(x='x',y='y',order=2,data=df)

Il semble en effet correspondre à une parabole quadratique classique.
Pour obtenir la régression de format, nous pouvons utiliser la technique de régression non linéaire avec Pingouin. Nous allons simplement ajouter une autre colonne à notre DataFrame pour élever les valeurs de x au carré :
df['x2'] = df['x']**2
Nous pouvons ensuite utiliser la régression linéaire pour ajuster la courbe quadratique :
pg.linear_regression(df[['x','x2']],df['y']).round(2)

Comme il s'agissait d'une création artificielle, le r² est de 1, ce qui indique un très bon ajustement, un que vous ne verriez probablement pas avec des données réelles.
Nous pouvons également construire un modèle prédictif en utilisant une fonction :
def quad(x):
return 3 + 2*x + 4*x**2
Vous pouvez également étendre cette méthode aux polynômes de degré supérieur à 2.
Régression logistique : ajustement des catégories binaires
Si vous voulez trouver une relation pour des catégories binaires, comme un certain facteur de risque, par exemple si une personne fume ou non, nous pouvons utiliser la régression logistique.
Le moyen le plus simple de visualiser cela est, une fois de plus, d'utiliser la librairie Seaborn. Nous allons charger le jeu de données des passagers du Titanic. Nous voulons voir si le prix du billet pouvait prédire qui survivrait ou non au voyage fatidique.
titanic = sns.load_dataset('titanic')
Nous pouvons examiner les données de la même manière que nous l'avons fait avec le DataFrame quadratique :
titanic.head()
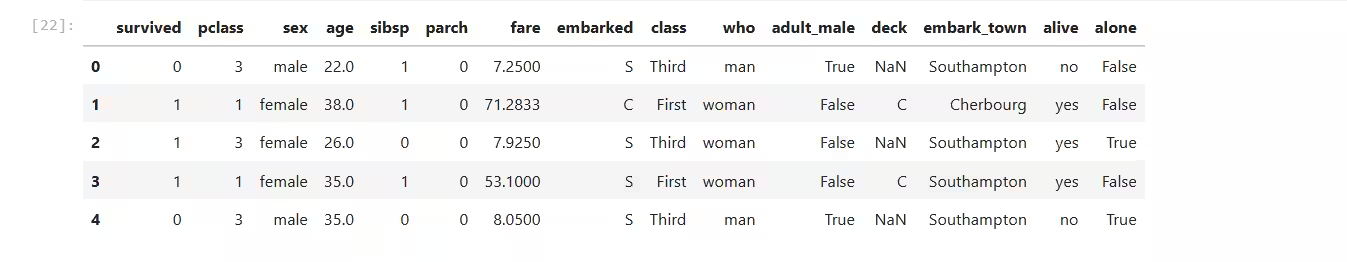
Nous utiliserons la méthode lmplot, car elle peut ajuster une courbe logistique :
sns.lmplot(x='fare',y='survived',logistic=True,data=titanic)
Nous voyons la courbe logistique en fonction du nombre de passagers, séparée selon qu'ils ont survécu ou non. La colonne « survécu » est déjà séparée en 0 pour « n'a pas survécu » et 1 pour « a survécu ».
Nous pouvons utiliser Pingouin pour déterminer formellement si le prix du billet était un facteur prédictif de la survie sur le Titanic, en utilisant Pingouin, qui, parmi ses nombreux tests statistiques, propose la régression logistique :
pg.logistic_regression(titanic['fare'],titanic['survived']).round(2)

Le chiffre auquel il faut prêter attention dans un test statistique est la valeur p, indiquée dans le tableau sous "pval." Elle est de 0,0, ce qui indique que le prix du billet était un prédicteur fort de la survie lors du voyage du Titanic.
Ces opérations montrent pourquoi Python est un langage de prédilection pour l'analyse de données. Elles permettent d'effectuer en quelques secondes des tâches qui pourraient prendre des jours à réaliser à la main, voire qui dépassaient ce que les statisticiens étaient disposés à faire. Ces opérations de régression vous aideront à trier vos données pour trouver des relations et faire des prédictions.