Comment utiliser le module de statistiques en Python
Liens rapides
- Qu'est-ce que le module statistiques de Python ?
- Statistiques descriptives
- Régression et Corrélation
- La distribution normale
- Qu'en est-il de NumPy, SciPy, etc. ?
Python dispose de certaines bibliothèques formidables pour l'analyse statistique, mais elles peuvent être excessives pour des tâches simples. La bibliothèque statistique intégrée pourrait être ce que vous cherchez à la place. Voici quelques-unes des choses que vous pouvez faire avec elle. Vous n'avez plus besoin de mémoriser des formules compliquées ou de consulter des tableaux.
Qu'est-ce que le module statistiques de Python ?
Le module statistics de Python est un module intégré pour effectuer des calculs statistiques simples. Étant donné qu'il fait partie de la bibliothèque standard de Python, il est disponible dans toutes les installations de Python. Pour y accéder dans des scripts ou des sessions interactives, il suffit de l'importer :
import statistics
Si vous n'avez besoin que d'une ou de quelques fonctions d'un module Python dans une session interactive, comme dans IPython ou un notebook Jupyter, vous pouvez les importer directement dans l'espace de noms courant, de sorte que vous n'ayez pas à taper "statistics" à chaque fois. C'est ce que supposeront les exemples de cet article.
Le module de statistiques brille dans un mode Python interactif comme l'interpréteur, une session améliorée dans IPython, ou un notebook Jupyter
Statistiques descriptives
La forme la plus basique des statistiques est la statistique descriptive. Comme son nom l'indique, ces statistiques ont pour but de décrire les données, telles que leurs tendances centrales ou leurs mesures de dispersion.
Le calcul le plus simple est la moyenne arithmétique, qui n'est autre que la somme des points de données divisée par le nombre de points de données. Dans les manuels de statistiques, la moyenne d'échantillon est représentée par un x avec une barre au-dessus, appelée « x-barre ». La moyenne de la population est représentée par la lettre grecque mu, mais c'est le même calcul. La plupart des gens connaissent cela sous le nom de « moyenne ».
Pour calculer la moyenne avec le module de statistiques, il suffit d'utiliser la fonction mean.
N'importez des fonctions dans l'espace de noms principal de Python uniquement lors des sessions interactives. Le faire peut provoquer des erreurs dans les scripts si la fonction importée remplace une fonction intégrée.
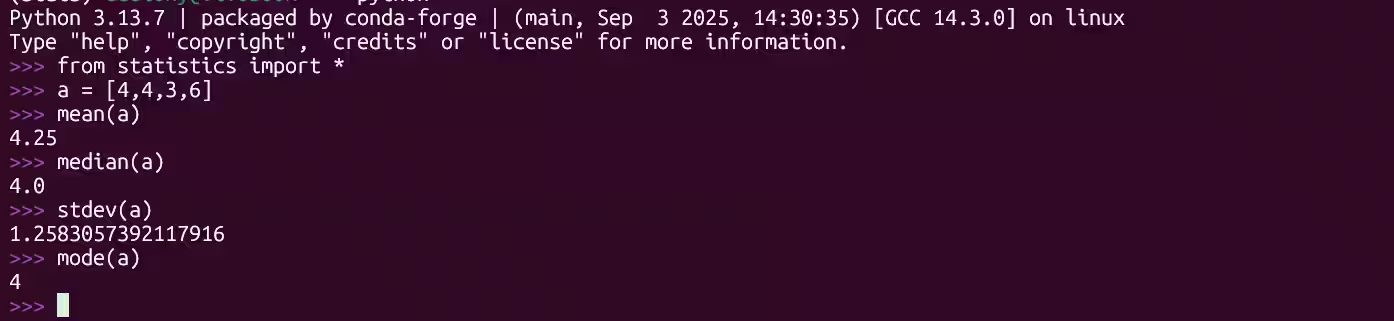
Créons un petit tableau de nombres et trouvons la moyenne :
a = [4,4, 3, 6]
mean(a)
Le résultat est 4,6.
La fonction fmean calcule également des moyennes, mais elle convertit les données en nombres à virgule flottante. Elle vous permet également de calculer une moyenne pondérée.
weights = [1,2,3,4]
fmean(a,weights)
La moyenne pondérée de cet exemple est de 4,5
Un autre type de moyenne est la moyenne géométrique, qui est utile pour comparer les taux de croissance sur une période de temps. Elle consiste à prendre la nième racine des points de données multipliés entre eux. À la main, cela signifie généralement des logarithmes fastidieux, mais c'est facile en Python avec la fonction geometric_mean.
geometric_mean(a)
La moyenne harmonique est le réciproque de la moyenne arithmétique. C'est le nombre de points de données divisé par la somme des fractions de 1/le premier point de données, 1/le deuxième point de données, et ainsi de suite. La moyenne harmonique est utile pour calculer la moyenne de choses comme les vitesses qui ont certains taux. Heureusement, Python peut également le faire pour vous.
harmonic_mean(a)
Le résultat est 4. Remarquez que la moyenne harmonique était inférieure à la moyenne géométrique, et que la moyenne géométrique était inférieure à la moyenne arithmétique sur le même ensemble de données.
La médiane est une autre mesure populaire de la tendance centrale. C'est le point de données qui divise un ensemble de données en deux. Vous pouvez la trouver avec la fonction médiane :
median(a)
Le résultat est 4 dans notre échantillon.
La fonction de mode indique le nombre le plus fréquent dans l'échantillon.
mode(a)
Encore une fois, la valeur la plus fréquente est 4, car c'est le nombre qui se répète le plus dans le tableau que nous avons défini précédemment.
Une autre raison courante d'utiliser les statistiques descriptives est de mesurer la dispersion des données, également appelée écart. La mesure de dispersion la mieux connue est l'écart type, qui mesure à quel point les données sont dispersées par rapport à la moyenne arithmétique. C'est la racine carrée de la variance, ou la somme du carré de la différence entre chaque valeur et la moyenne, divisée par le nombre de valeurs. Cela représente l'écart type de la population, mais l'écart type soustrait un à ce nombre pour donner un résultat plus représentatif dans les petits échantillons.
La fonction stdev calcule l'écart type de l'échantillon, ce qui sera probablement ce que vous voudrez la plupart du temps :
stdev(a)
Le résultat est d'environ 1,26.
Comparons-le à l'écart-type de la population avec la fonction pstdev :
pstdev(a)
Vous pouvez consulter la variance de l'échantillon avec la fonction variance
variance(a)
Il existe également une variante basée sur la population, pvariance, qui fonctionne de la même manière.
Une autre manière de visualiser la répartition de vos données consiste à les diviser en percentiles, c'est-à-dire le pourcentage de points de données qui sont inférieurs à ce seuil. La médiane correspond en fait au 50e percentile, puisque la moitié des points de données se situe en dessous.
La fonction quantiles divisera les données en percentiles selon le résultat :
quantiles(a)
Il affichera le quartile inférieur, ou 25e percentile, la médiane et le quartile supérieur. Les fonctions intégrées min et max afficheront les valeurs minimale et maximale.
min(a)
max(a)
Régression et Corrélation
Une méthode statistique populaire consiste à observer comment une variable est corrélée à une autre. Cela revient à tracer des points de données sur des axes x et y et à tracer une ligne au-dessus pour voir dans quelle mesure elle s'adapte. Cela s'appelle la "régression linéaire." Le module de statistiques dispose d'une méthode pour la régression linéaire simple. Elle est "simple" car elle ne corrèle que deux variables. Elle utilise une méthode appelée "moindres carrés ordinaires," ainsi nommée car elle tente de minimiser le carré de la distance entre les points de données et la ligne qu'elle crée.
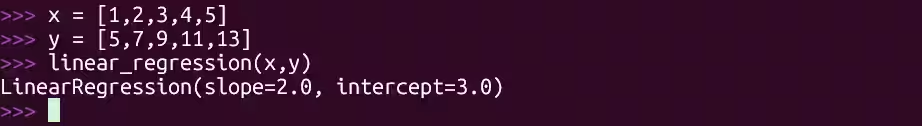
Traçons une régression linéaire de deux tableaux étiquetés x et y
x = [1,2,3,4,5]
y = [5,7,9,11,13]
Pour ajuster le modèle, utilisez la méthode linear_regression. Cela calculera la pente et l'ordonnée à l'origine pour l'équation familière d'une droite : y=mx + b.
linear_regression(x,y)
Cela vous donnera la pente et l'ordonnée à l'origine. Vous pouvez également les enregistrer dans des variables :
slope, intercept = linear_regression(x,y)
La pente dans ce cas est de 2 et l'ordonnée à l'origine est de 3, représentant l'équation de la forme pente-interception y=2*x + 3. Le signe positif de la pente indique qu'il s'agit d'une droite qui monte, ce qui signifie que la valeur de y augmentera lorsque l'on se déplace vers la droite.
Cette fonction ne tracera aucune ligne ni le diagramme de dispersion classique. Elle ne fournira également la régression que pour deux variables. Si vous souhaitez générer un graphique ou faire une prédiction en utilisant plus d'une variable dépendante, vous devrez utiliser d'autres bibliothèques telles que Seaborn, statsmodels ou Pingouin.
Vous pouvez voir à quel point deux variables sont corrélées en utilisant la fonction de corrélation. Cela calcule le coefficient de corrélation, ou r. Ce coefficient sera compris entre 0 et 1 ou -1, indiquant une corrélation positive ou négative. Une corrélation négative signifiera une ligne décroissante.
Pour vérifier la corrélation entre deux variables :
correlation(x,y)
Dans ce cas, c'est 1, montrant une corrélation positive parfaite, mais les données réelles ne corrèlent que rarement aussi parfaitement. Cela signifie que la ligne de régression s'alignera parfaitement sur les points de données lorsque vous les tracerez.
La distribution normale

La distribution normale, avec sa célèbre courbe en forme de cloche, est une distribution de probabilité continue. Vous pouvez utiliser cette fonction pour estimer la probabilité d'un paramètre distribué normalement.
Nous pouvons démontrer cela avec des données provenant des CDC. Selon les données, la moyenne des hommes de plus de 20 ans est de 175,1 centimètres. Nous pouvons obtenir l'écart-type de la population en multipliant la racine carrée du nombre d'échantillons, 2 690, par l'erreur standard, 0,3.
import math
math.sqrt(2690) * .3
L'écart type est d'environ 15,56
Nous pouvons utiliser cela pour créer un objet de distribution normale :
men_height = NormalDist(175.1,28.41)
Pour trouver le pourcentage d'hommes dont la taille est comprise entre 160 et 180 centimètres, nous utilisons la fonction de répartition cumulative, ou CDF, qui donne le pourcentage de valeurs d'une variable simple en dessous d'une certaine valeur. Nous pouvons soustraire la valeur inférieure de la valeur supérieure car la courbe de distribution normale est symétrique. L'objet que nous venons de créer possède une méthode cdf que nous pouvons utiliser pour obtenir cette probabilité.
men_height.cdf(180) - men_height.cdf(160)
La réponse sera qu'environ 45 % des hommes mesurent entre 160 et 180 centimètres.
Qu'en est-il de NumPy, SciPy, etc. ?
NumPy, SciPy et d'autres bibliothèques sont populaires pour les statistiques et l'analyse de données. Qu'en est-il du module statistiques ? Les bibliothèques précédentes sont conçues pour de grands ensembles de données et une utilisation professionnelle. Les développeurs du module statistiques l'ont destiné à des niveaux comparables à ceux des calculatrices scientifiques et graphiques. Cette bibliothèque est adéquate pour apprendre les concepts statistiques et effectuer des calculs rapides et occasionnels.
Si vous voulez travailler avec de vrais ensembles de données, les autres bibliothèques seront plus puissantes et flexibles, bien que la courbe d'apprentissage puisse être raide. Si vous voulez avoir un aperçu de la puissance du calcul statistique avec Python, le module de statistiques est un bon point de départ.