Comment valider vos données avec des tests statistiques en Python
Liens rapides
- Qu'est-ce que le test d'hypothèse ?
- Pourquoi les tests statistiques ?
- Test t de Student
- Régression Linéaire
- ANOVA
- Tests non paramétriques
Avoir des données n'est que la moitié de la bataille. Comment savoir si vos données ont réellement une signification ? Avec un peu de code Python simple, vous pouvez rapidement vérifier si les différences dans les données sont réellement significatives.
Qu'est-ce que le test d'hypothèse ?
En statistique, le test d'hypothèse est l'utilisation de techniques pour vérifier si les résultats d'un échantillon ou d'un groupe d'échantillons sont statistiquement significatifs. En d'autres termes, le test d'hypothèse détermine si les résultats sont dus au hasard ou non. Le test d'hypothèse quantifie la différence entre les échantillons pour déterminer si elle est significative.
Les chercheurs formulent généralement une hypothèse nulle, qui suppose que les résultats ne sont pas significatifs, puis essaient de la réfuter au profit d'une hypothèse alternative, selon laquelle les résultats sont statistiquement significatifs. C'est comme la présomption d'innocence au tribunal, où un accusé est présumé innocent jusqu'à preuve du contraire. Les chercheurs supposeront que les résultats ne sont pas statistiquement significatifs jusqu'à ce que le test rejette l'hypothèse nulle.
Un bon exemple est un essai clinique pour un nouveau médicament. Un groupe de patients recevra un placebo, et l'autre le médicament testé. Les groupes seront évalués pour déterminer si le médicament a un effet significatif. Si le médicament est destiné à contrôler la tension artérielle, un test pourrait comparer la pression artérielle systolique entre les groupes.
Historiquement, les tests étaient effectués en utilisant des formules mathématiques et des tableaux trouvés dans des manuels et au verso des manuels de statistiques ; cependant, les logiciels modernes, y compris les bibliothèques Python, rendent cette tâche beaucoup plus rapide de nos jours. C'est une autre raison pour laquelle Python est si génial pour l'analyse de données avancée.
Les tests statistiques sont généralement effectués dans une certaine limite, appelée niveau alpha. Pour être sûr des résultats à 95 %, l'alpha serait de 0,05, correspondant à un niveau de signification de 5 %. Si vous souhaitez être sûr à 99 %, l'alpha serait de 0,01. Cela forme une valeur p que vous devez vérifier pour accepter ou rejeter l'hypothèse nulle. À un niveau de 95 %, vous rejetteriez l'hypothèse nulle si la valeur p était inférieure à 0,05, et à un niveau de 99 %, si elle était inférieure à 0,01.
Une version antérieure de cet article confondait les définitions des faux positifs et des faux négatifs. Une erreur de type I est un faux positif, et une erreur de type II est un faux négatif. HTG regrette cette erreur.
Dans les tests d'hypothèse, il est possible de commettre deux erreurs majeures. Une erreur de type I, ou faux positif, se produit lorsque vous rejetez une hypothèse alors qu'elle devrait être acceptée. Une erreur de type II, ou faux négatif, se produit lorsque vous acceptez une hypothèse alors qu'elle devrait être rejetée.
Les erreurs dans les tests d'hypothèses peuvent avoir des conséquences graves, comme dans un essai clinique, lorsque l'hypothèse alternative selon laquelle un médicament est efficace est acceptée alors qu'il peut être inefficace ou même nocif. La meilleure défense contre les deux types d'erreurs est d'avoir une taille d'échantillon aussi grande que possible.
Déterminez les hypothèses nulles et alternatives, ainsi que le niveau de signification, avant de tester, afin d'éviter d'être excessivement influencé par les résultats du test.
Pourquoi les tests statistiques ?
Les tests statistiques sont utilisés parce que, pris isolément, il est difficile de dire si les données ont une signification. Si une entreprise pharmaceutique veut commercialiser un nouveau médicament, il faut démontrer que le médicament est réellement efficace. C'est là que les essais cliniques entrent en jeu. Ou bien, vous pourriez être dans un domaine comme les études de marché où vous voulez montrer que les consommateurs qui achètent un produit sont susceptibles d'en acheter un autre.
Les tests statistiques ne se limitent pas à effectuer des calculs, mais impliquent également de réfléchir de manière critique aux données.
Test t de Student
Les tests statistiques sont généralement introduits dans les cours de statistiques élémentaires avec la distribution normale, avec la célèbre courbe en cloche, car ses calculs sont simples. Ils sont peu pratiques pour la plupart des recherches réelles pour deux raisons : ils nécessitent la connaissance de l'écart type de la population, que le chercheur n'a probablement pas, ainsi que des tailles d'échantillon plus grandes, qui peuvent être difficiles à obtenir pour les chercheurs.
Pour surmonter ces limitations, lorsque la distribution des données paraît similaire à la distribution normale, le test t de Student est utilisé à la place dans de nombreuses recherches réelles. L'hypothèse nulle est généralement que la moyenne d'un échantillon est égale à une certaine valeur ou que les moyennes de deux échantillons sont égales.
La bibliothèque Pingouin est utile pour réaliser des tests statistiques, y compris le test t.
Je vais simuler un test en utilisant des nombres générés aléatoirement à partir de la distribution normale. Tout d'abord, je vais importer NumPy et invoquer le générateur de nombres aléatoires.
import numpy as np
rng = np.random.default_rng()
Vous pouvez voir cet exemple de code et d'autres dans un notebook Jupyter que j'ai publié sur ma page GitHub. Maintenant, générez un petit échantillon de valeurs à partir de la distribution normale de 15 éléments.
a = rng.standard_normal(15)Le test t suppose que les valeurs proviennent d'une distribution normale. Nous savons que c'est le cas pour cet échantillon car elles ont été générées à partir de la distribution normale, mais Pingouin dispose d'un test pour le déterminer en utilisant le test de Shapiro-Wilk pour les petits échantillons.
import pingouin as pg
pg.normality(a)

Testons cela par rapport à l'hypothèse nulle en utilisant la bibliothèque Pingouin, selon laquelle la moyenne de cet échantillon est de 0,45 :
pg.ttest(a,.45)La valeur p est de 0,99, ce qui signifie que nous ne pouvons pas rejeter l'hypothèse nulle ni à un niveau alpha de 0,05 ni à un niveau de 0,01.
Régression linéaire
Vous avez peut-être déjà vu la régression linéaire, où l'on ajuste une droite sur un ensemble de points de données, mais vous ne savez peut-être pas qu'un test statistique est impliqué. Le modèle de régression linéaire de Pinguin rapporte une statistique t et une valeur p. Cela teste l'hypothèse nulle selon laquelle la pente, ou l'inclinaison, de la droite de régression est nulle, c'est-à-dire qu'il s'agit d'une ligne horizontale. La valeur p est si faible qu'elle est ici représentée en notation scientifique.
Nous pouvons visualiser la régression avec une autre bibliothèque, Seaborn. Seaborn inclut beaucoup de données d'exemple pour tester. Nous allons utiliser un ensemble de données sur les pourboires des restaurants de New York. Nous allons le charger :
import seaborn as sns
tips = sns.load_dataset('tips')
Nous allons examiner le jeu de données pour voir quels champs sont disponibles. Il s'agit d'un objet DataFrame de pandas, qui est similaire à une base de données SQL. Nous allons utiliser la méthode head :
tips.head()
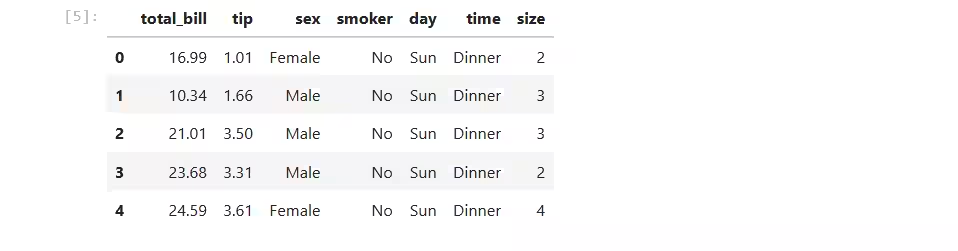
Comparons le montant total de l'addition avec celui du pourboire. Nous tracerons une ligne de régression sur un nuage de points représentant le pourboire par rapport à l'addition, avec l'addition sur l'axe des x et le pourboire sur l'axe des y :
sns.regplot(x='total_bill',y='tip')

Vous pourriez remarquer que cela semble être un bon choix.
Nous pouvons également utiliser la méthode linear_regression de Pingouin pour une analyse plus formelle, ainsi que l'arrondir pour rendre les valeurs plus faciles à visualiser :
pg.linear_regression(tips['tip'],tips['total_bill']).round(2)

Vous pouvez voir les valeurs des coefficients pour la droite de régression, mais notez la valeur t et la valeur p. Cela montre que nous pouvons rejeter l'hypothèse nulle selon laquelle la pente est égale à 0. Plus la pente s'éloigne de 0, plus la valeur t est élevée. Dans cet exemple, la valeur t est de 14,26. La valeur p est de 0,0, ce qui indique que les résultats seraient significatifs à tout niveau alpha.
ANOVA
Alors que le test t compare un échantillon ou plusieurs échantillons, et que la régression examine les associations entre une variable et une autre, l'ANOVA, ou Analyse de la Variance, examine une valeur au sein d'une catégorie. Nous utiliserons à nouveau Pingouin pour examiner la longueur des nageoires des manchots selon les espèces. Pour l'hypothèse nulle, nous supposerons qu'il n'y a pas de différence entre les espèces.
penguins = pg.read_dataset('penguins')
pg.anova(data=penguins,dv='flipper_length_mm',between='species').round(2)

Comme la valeur p est de 0,0, nous pouvons rejeter l'hypothèse nulle et conclure que l'espèce est un prédicteur significatif de la longueur des nageoires.
Tests non paramétriques
Un problème courant des tests statistiques est qu'ils supposent que les données suivent une certaine distribution. Par exemple, le test t suppose que les données sont distribuées normalement. Beaucoup de données réelles, en particulier celles générées par l'activité humaine, sont biaisées. Les tests non paramétriques essaient de contourner ce problème en ne supposant aucune distribution particulière des données.
Le test U de Mann-Whitney est un équivalent non paramétrique du test t de Student. Il est également inclus avec Pingouin. Commençons par générer deux listes de nombres aléatoires :
a = rng.random(15)
b = rng.random(15)
Voyons si les moyennes sont égales en utilisant le test U de Mann-Whitney :
pg.mwu(a,b)
Il existe également une version non paramétrique de l'ANOVA, le test de Kruskal-Wallis. Nous pouvons l'utiliser à nouveau avec nos données sur les manchots :
pg.kruskal(data=penguins,dv='flipper_length_mm',between='species').round(2)

Nous obtenons des résultats similaires à ceux de notre test ANOVA initial, selon lequel l'espèce est un prédicteur significatif de la longueur des nageoires.
Les tests statistiques en Python offrent un moyen de s'assurer que vos données sont significatives. Il ne faut qu'une seconde pour valider vos données.