Comment créer un hotstandby avec PostgreSQL
Avec des bases de données telles que PostgreSQL, il peut être nécessaire d’évoluer et de fournir une haute disponibilité. Si la base de données ne dispose pas d’une sauvegarde qui puisse la remplacer en cas de défaillance, toutes vos opérations qui dépendent de la base de données peuvent être affectées à partir d’un seul point de défaillance. Même avec des systèmes virtuels, il peut arriver que vous ne puissiez pas ajouter de ressources supplémentaires à une seule machine pour faire face à la charge toujours croissante.
Il peut également être nécessaire de disposer d’une copie supplémentaire du contenu de la base de données qui peut être interrogée pour des analyses de longue durée, qui ne sont pas adaptées à l’exécution sur la base de données de production à forte intensité de transactions. Il peut s’agir d’une simple restauration à partir de la sauvegarde la plus récente sur une autre machine, mais les données sont obsolètes dès qu’elles sont restaurées. Nous pouvons créer un hot-standby en faisant une copie de la base de données primaire et en le configurer pour répliquer constamment son contenu sur le standby.
Pour ces raisons, il est avantageux de disposer d’une réserve à chaud pour votre base de données PostgreSQL. En cas d’échec sur la base de données maître, la base de données de secours (ou esclave) peut prendre le rôle de base de données principale, arrêter la synchronisation et accepter les demandes de lecture et d’écriture, de sorte que les opérations peuvent se poursuivre et que le maître ayant échoué peut être ramené à la vie (peut-être en tant que serveur de secours en changeant le mode de synchronisation). Lorsque le serveur principal et le serveur de secours sont en cours d’exécution, les requêtes qui ne tentent pas de modifier le contenu de la base de données peuvent être déchargées sur le serveur de secours, de sorte que l’ensemble du système est en mesure de gérer une charge plus importante. Notez cependant qu’il y aura un certain retard – le standby sera derrière le maître, dans la limite du temps nécessaire à la synchronisation des modifications. Ce délai peut varier en fonction de la configuration.
Il existe de nombreuses façons de construire une synchronisation maître-esclave (ou même maître-maître) avec PostgreSQL, mais dans ce guide, nous nous concentrerons sur la réplication en continu. Dans ce tutoriel, nous allons passer en revue les instructions étape par étape de configuration d’une base de données PostgreSQL de secours. Les bases de données seront configurées sur deux serveurs différents, de sorte que le serveur de secours puisse facilement être remplacé par le serveur principal en cas de défaillance.
Dans ce tutoriel, vous allez apprendre :
- Comment installer le serveur PostgreSQL
- Comment configurer un utilisateur de réplication dans PostgreSQL
- Comment créer une configuration de secours à chaud
- Comment tester la réplication de base de données pour PostgreSQL

Configuration PostgreSQL pour le serveur maître
Nous allons commencer par configurer PostgreSQL sur le serveur maître. Il doit s’agir du système qui fournit des services de base de données à vos applications et utilisateurs. Il aura besoin d’appliquer des paramètres particuliers afin de répliquer son contenu dans une base de données secondaire, que nous configurerons par la suite.
avertissement!
Si vous travaillez avec une base de données de production, il est généralement judicieux de sauvegarder tous les fichiers de configuration avant d’apporter des modifications. Ils ne prennent pas de place digne d’être mentionnée, et en cas de problème, la sauvegarde d’un fichier de configuration fonctionnel peut vous sauver la vie.
Les étapes ci-dessous couvriront les distributions basées sur Debian (comme Ubuntu) et basées sur Red Hat (Fedora, Almalinux, etc.).
Nous allons commencer par installer le serveur PostgreSQL sur notre système Linux. Ce processus aura lieu sur les deux systèmes, si vous n’avez pas déjà installé PosteSQL. Les utilisateurs basés sur Debian peuvent utiliser la commande
apt:sudo apt install postgresqlEt les utilisateurs basés sur Red Hat peuvent utiliser la commande
dnf:sudo dnf install postgresql-serverNotez que vous devrez exécuter la commande suivante sur les distributions basées sur Red Hat après l’installation :
sudo postgresql-setup initdbEnsuite, exécutez la commande suivante sur les deux serveurs pour vous assurer que les bases de données PostgreSQL démarrent automatiquement :
sudo systemctl enable postgresqlSur le serveur primaire (maître), nous devons modifier le fichier
pg_hba.confpour appliquer les paramètres de réplication. Ouvrez ce fichier dans l’éditeur de texte de votre choix et avec les privilèges root :Debian based systems: sudo nano /etc/postgresql/16/main/pg_hba.conf Red Hat based systems: sudo nano /var/lib/pgsql/data/pg_hba.confÀ l’intérieur de ce fichier, nous devons ajouter une règle qui permettra à l’utilisateur de la base de données de la veille d’accéder à la primaire. Il s’agit du paramètre côté serveur, l’utilisateur n’existe pas encore dans la base de données. Vous pouvez trouver des exemples à la fin du fichier commenté qui sont liés à la base de données de réplication :
Allow replication connections from localhost, by a user with the
replication privilege.
local   replication     all                                     peer
host    replication     all             127.0.0.1/32            scram-sha-256
host    replication     all             ::1/128                 scram-sha-256
Ajoutons une autre ligne à la fin du fichier et marquons-la avec un commentaire afin qu’on puisse voir facilement ce qui a changé par rapport aux valeurs par défaut :
My custom replication settings
host    replication     repuser         192.168.68.65/32  md5
Notez que
192.168.68.65est l’adresse IP de notre serveur secondaire. Le masque de sous-réseau/32fait en sorte que seul notre hôte particulier puisse accéder à la base de données primaire à partir de ce paramètre. Votre fichier doit ressembler à la capture d’écran ci-dessous :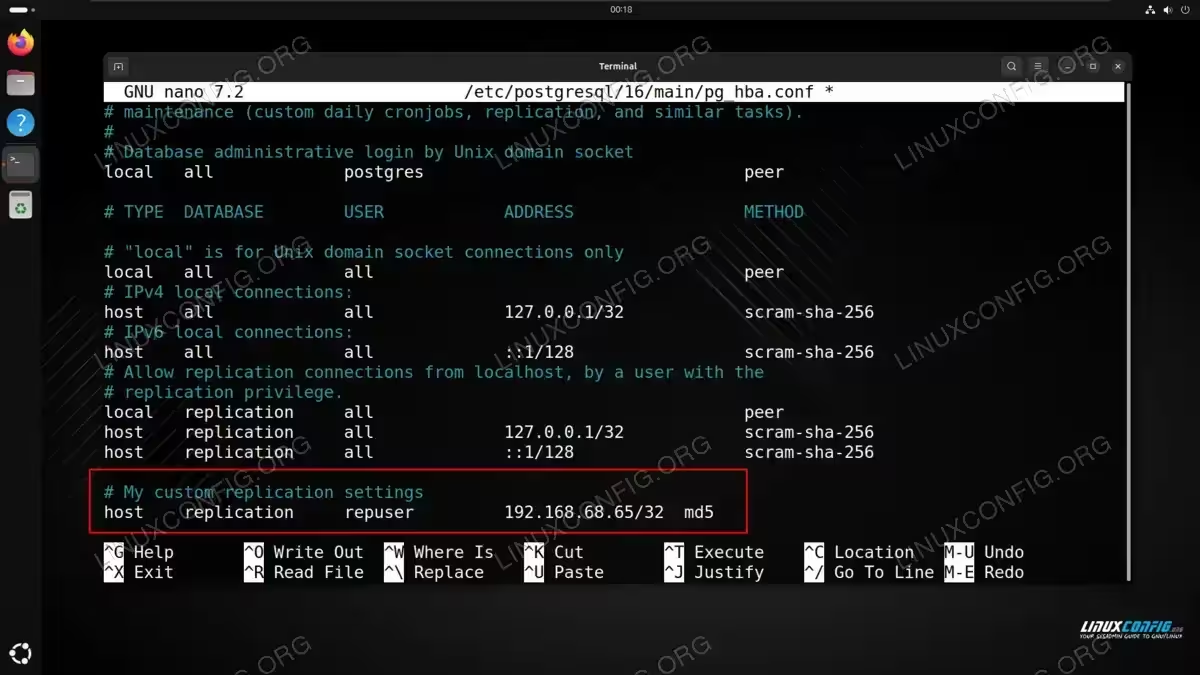
Enregistrez vos modifications dans ce fichier et quittez-le.
Nous devons également apporter des modifications au fichier de configuration principal du serveur de base de données,
postgresql.conf, qui se trouve dans le même répertoire que le fichierpg_hba.conf. Nous devrons appliquer les paramètres suivants :listen_addresses = '*' wal_level = 'replica' archive_mode = on archive_command = 'cp %p /etc/postgresql/16/main/%f' max_wal_senders = 3 wal_keep_size = 64Tous ces paramètres existent déjà à l’intérieur du fichier, mais ils sont commentés. Plutôt que de trouver chacun d’entre eux et d’appliquer les paramètres un par un, il est plus facile et tout aussi efficace de simplement coller toutes les lignes au bas du fichier :
Maintenant que tous les paramètres nécessaires sont configurés, démarrons le serveur principal :
sudo systemctl start postgresqlEnfin, nous devons créer l’utilisateur de la base de données qui s’occupera de la réplication :
sudo -u postgres psql

postgres=# CREATE ROLE repuser WITH REPLICATION PASSWORD 'secretPassword' LOGIN;
CREATE ROLE
Prenez note du mot de passe que vous donnez à l’utilisateur
repuser, car nous en aurons besoin du côté veille. La sortieCREATE ROLEconfirme que nous avons correctement créé l’utilisateur.Avant de passer au serveur secondaire, nous devrons redémarrer PostgreSQL pour que nos modifications prennent effet :
sudo systemctl restart postgresql
Configuration PostgreSQL pour le serveur esclave
À ce stade, nous pouvons passer au serveur secondaire (esclave). Suivez les étapes ci-dessous pour configurer ce serveur en tant que serveur de secours pour le serveur maître que nous avons déjà configuré ci-dessus :
En suivant la section ci-dessus, vous devriez déjà avoir configuré le serveur esclave avec PostgreSQL. Ensuite, nous allons travailler en tant qu’utilisateur
postgres, qui est le superutilisateur dans le contexte de la base de données. Nous aurons besoin d’une copie initiale de la base de données primaire, et nous l’obtiendrons avec la commandepg_basebackup. Tout d’abord, nous effacons le répertoire de données en veille de la plupart des fichiers (faites une copie au préalable si vous le souhaitez, mais il ne s’agit que d’une base de données vide). Nous laisserons deux dossiers intacts :Debian based systems: sudo find /etc/postgresql/16/main ! -name 'pg_hba.conf' ! -name 'pg_ident.conf' -exec rm -f {} + Red Hat based systems: sudo find /var/lib/pgsql/data ! -name 'pg_hba.conf' ! -name 'pg_ident.conf' -exec rm -f {} +Cela supprimera tous les fichiers
à l’exception de pg_hba.confetpg_ident.conf, que nous devons conserver sur le système.Nous sommes maintenant prêts à effectuer une copie cohérente de la base de données primaire dans la base de données de secours :
Debian based systems:
sudo pg_basebackup -h 192.168.68.64 -U repuser -D /etc/postgresql/16/main/

Red Hat based systems:
sudo pg_basebackup -h 192.168.68.64 -U repuser -D /var/lib/pgsql/data/
Notez que dans cet exemple,
192.168.68.64est l’adresse IP de notre serveur maître.repuserest le nom de l’utilisateur que nous avons configuré précédemment. Vous devriez être invité à saisir votre mot de passe lors de l’exécution de la commande.REMARQUE
Comme le principal est vide à côté de cet utilisateur que nous avons créé, lepg_basebackupdevrait se terminer en quelques secondes (en fonction de la bande passante du réseau). En cas de problème, vérifiez les règlesHBAsur le serveur primaire, l’exactitude de l’adresse IP donnée à la commandepg_basebackupet le fait que le port 5432 sur le port principal est accessible à partir du mode veille (par exemple, avec telnet).Une fois la sauvegarde terminée, vous remarquerez que le répertoire de données est rempli sur l’esclave, y compris les fichiers de configuration (rappelez-vous, nous avions précédemment tout supprimé de ce répertoire) :
Debian based systems:
sudo ls /etc/postgresql/16/main

Red Hat based systems:
sudo ls /var/lib/pgsql/data
Sortie:
backup_label.old  pg_commit_ts	 pg_logical    pg_serial     pg_subtrans  pg_wal		postmaster.opts
backup_manifest   pg_dynshmem	 pg_multixact  pg_snapshots  pg_tblspc	  pg_xact		postmaster.pid
base		  pg_hba.conf	 pg_notify     pg_stat	     pg_twophase  postgresql.auto.conf	standby.signal
global		  pg_ident.conf  pg_replslot   pg_stat_tmp   PG_VERSION   postgresql.conf
Nous devons maintenant apporter quelques ajustements à la configuration de la veille. L’adresse IP à partir de laquelle le
repèrepeut se connecter doit être l’adresse du serveur maître dans le fichierpg_hba.conf. Ajoutez la ligne suivante au bas du fichier, où vous substituez l’adresse IP de votre propre maître à celle que nous avons configurée ci-dessous :File location: Debian based: sudo nano /etc/postgresql/16/main/pg_hba.conf Red Hat based: sudo nano /var/lib/pgsql/data/pg_hba.confCopiez et collez la ligne suivante vers le bas :
My custom replication settings
host    replication     repuser         192.168.68.64/32         md5
Remarque : Remplacez
192.168.68.64ci-dessus par l’adresse IP de votre serveur maître.Nous avons tout en place, nous pouvons donc démarrer le stand-by et voir si tout fonctionne comme il se doit :
sudo systemctl start postgresqlIl se peut que la récupération de l’invite prenne un peu plus de temps que d’habitude. La raison en est que la base de données effectue la récupération jusqu’à un état cohérent en arrière-plan.
Vérifiez dans le fichier journal si votre base de données est passée en mode veille et a commencé à faire une copie de la base de données primaire :
Debian based systems:
tail -f /var/log/postgresql/postgresql-16-main.log

Red Hat based systems:
tail -f /var/lib/pgsql/data/log/postgresql-Sun.log
(the name of this log file will change depending on the day of the week)
Le résultat attendu doit ressembler à ceci :
2024-09-01 22:59:50.068 GMT [4350] LOG:  entering standby mode
2024-09-01 22:59:50.069 GMT [4350] LOG:  starting backup recovery with redo LSN 0/6000028, checkpoint LSN 0/6000060, on timeline ID 1
2024-09-01 22:59:50.087 GMT [4350] LOG:  redo starts at 0/6000028
2024-09-01 22:59:50.088 GMT [4350] LOG:  completed backup recovery with redo LSN 0/6000028 and end LSN 0/6000100
2024-09-01 22:59:50.088 GMT [4350] LOG:  consistent recovery state reached at 0/6000100
2024-09-01 22:59:50.088 GMT [4347] LOG:  database system is ready to accept read-only connections
2024-09-01 22:59:50.127 GMT [4351] LOG:  started streaming WAL from primary at 0/7000000 on timeline 1
Réflexions finales
Dans ce tutoriel, nous avons vu comment mettre en place un hotstandby pour une base de données PostgreSQL sur un système Linux. Après la configuration, notre serveur secondaire est prêt avec une copie 1:1 de la base de données primaire en cas de panne. Il s’agit d’un processus simple et direct pour remplacer les bases de données en cas de panne de la base de données principale. De plus, nous pouvons exécuter des tests et des requêtes sur le serveur secondaire afin de ne pas interférer avec les opérations du serveur primaire.