Fonctions de perte en Python - Mise en œuvre facile

Les fonctions de perte en Python sont une partie intégrante de tout modèle d'apprentissage automatique. Ces fonctions nous indiquent dans quelle mesure la sortie prédite du modèle diffère de la sortie réelle.
Il existe plusieurs façons de calculer cette différence. Dans ce tutoriel, nous allons examiner certaines des fonctions de perte les plus populaires.
Nous allons discuter des quatre fonctions de perte suivantes dans ce tutoriel.
- Erreur quadratique moyenne
- Erreur quadratique moyenne
- Erreur Absolue Moyenne
- Perte d'entropie croisée
Parmi ces 4 fonctions de perte, les trois premières s'appliquent aux régressions et la dernière s'applique dans le cas des modèles de classification.
Implémentation des fonctions de perte en Python
Voyons comment implémenter ces fonctions de perte en Python.
1. Erreur Quadratique Moyenne (EQM)
L'erreur quadratique moyenne (EQM) est calculée comme la moyenne des carrés de la différence entre les prédictions et les observations réelles. Mathématiquement, nous pouvons la représenter comme suit :

L'implémentation Python pour MSE est la suivante :
import numpy as np
def mean_squared_error(act, pred):

   diff = pred - act
   differences_squared = diff ** 2
   mean_diff = differences_squared.mean()

   return mean_diff

act = np.array([1.1,2,1.7])
pred = np.array([1,1.7,1.5])

print(mean_squared_error(act,pred))
Sortie :
0.04666666666666667
Vous pouvez également utiliser mean_squared_error de sklearn pour calculer l'EMM. Voici comment la fonction fonctionne:
from sklearn.metrics import mean_squared_error
act = np.array([1.1,2,1.7])
pred = np.array([1,1.7,1.5])
mean_squared_error(act, pred)
Sortie :
0.04666666666666667
2. Erreur quadratique moyenne (EQM)
L'erreur quadratique moyenne (RMSE) est calculée comme la racine carrée de l'erreur quadratique moyenne. Mathématiquement, nous pouvons la représenter comme suit :

L'implémentation Python pour l'EMMQ est comme suit :
import numpy as np
def root_mean_squared_error(act, pred):

   diff = pred - act
   differences_squared = diff ** 2
   mean_diff = differences_squared.mean()
   rmse_val = np.sqrt(mean_diff)
   return rmse_val

act = np.array([1.1,2,1.7])
pred = np.array([1,1.7,1.5])

print(root_mean_squared_error(act,pred))
Sortie :
0.21602468994692867
Vous pouvez également utiliser mean_squared_error de sklearn pour calculer la RMSE. Voyons comment implémenter la RMSE en utilisant la même fonction :
from sklearn.metrics import mean_squared_error
act = np.array([1.1,2,1.7])
pred = np.array([1,1.7,1.5])
mean_squared_error(act, pred, squared = False)
Sortie :
0.21602468994692867
Si le paramètre ‘carré’ est défini sur Vrai, alors la fonction retourne la valeur de MSE. S'il est défini sur Faux, la fonction retourne la valeur de RMSE.
3. Erreur Absolue Moyenne (EAM)
L'erreur absolue moyenne (MAE) se calcule comme la moyenne de la différence absolue entre les prévisions et les observations réelles. Mathématiquement, nous pouvons le représenter comme suit :
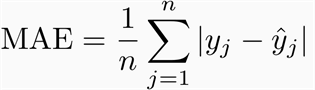
L'implémentation Python pour MAE est la suivante :
import numpy as np
def mean_absolute_error(act, pred):
    diff = pred - act
    abs_diff = np.absolute(diff)
    mean_diff = abs_diff.mean()
    return mean_diff

act = np.array([1.1,2,1.7])
pred = np.array([1,1.7,1.5])
mean_absolute_error(act,pred)
Sortie :
0.20000000000000004
Vous pouvez également utiliser mean_absolute_error de sklearn pour calculer le MAE.
from sklearn.metrics import mean_absolute_error
act = np.array([1.1,2,1.7])
pred = np.array([1,1.7,1.5])
mean_absolute_error(act, pred)
Sortie :
0.20000000000000004
4. Fonction de perte d'entropie croisée en Python
La perte d'entropie croisée est également connue sous le nom de vraisemblance logarithmique négative. Cela est le plus souvent utilisé pour les problèmes de classification. Un problème de classification est celui où vous classifiez un exemple comme appartenant à l'une de plus de deux classes.
Voyons comment calculer l'erreur dans le cas d'un problème de classification binaire.
Considérons un problème de classification où le modèle essaie de classer entre un chien et un chat.
Le code python pour trouver l'erreur est donné ci-dessous.
from sklearn.metrics import log_loss
log_loss(["Dog", "Cat", "Cat", "Dog"],[[.1, .9], [.9, .1], [.8, .2], [.35, .65]])
Sortie :
0.21616187468057912
Nous utilisons la méthode log_loss de sklearn.
Le premier argument dans l'appel de fonction est la liste des étiquettes de classe correctes pour chaque entrée. Le deuxième argument est une liste de probabilités telles que prédites par le modèle.
Les probabilités sont dans le format suivant :
[P(dog), P(cat)]
Conclusion
Ce tutoriel portait sur les fonctions de perte en Python. Nous avons couvert différentes fonctions de perte pour les problèmes de régression et de classification. J'espère que vous vous êtes amusé à apprendre avec nous !