EDA - Analyse Exploratoire des Données : Utiliser des Fonctions Python

Dans les articles précédents, nous avons vu comment effectuer une EDA à l'aide de méthodes graphiques. Dans cet article, nous allons nous concentrer sur les fonctions Python utilisées pour l'Analyse Exploratoire des Données en Python. Comme nous le savons tous, l'EDA est très important car il fournit une compréhension brève des données. Donc, sans perdre trop de temps, lançons-nous !
Analyse des données exploratoires - EDA
- L'EDA est appliquée pour examiner les données et résumer les principaux enseignements.
- Cela vous donnera une compréhension de base de vos données, de leur répartition, des valeurs nulles et bien plus encore.
- Vous pouvez soit explorer les données à l'aide de graphiques, soit à travers certaines fonctions python.
- Il y aura deux types d'analyse. Uni-variée et Bi-variée. Dans l'analyse univariée, vous allez analyser un seul attribut. Mais dans l'analyse bivariée, vous allez analyser un attribut avec l'attribut cible.
- Dans l'approche non graphique, vous utiliserez des fonctions telles que forme, résumé, décrire, isnull, info, types de données et plus encore.
- Dans l'approche graphique, vous utiliserez des graphiques tels que des nuages de points, des boîtes à moustaches, des histogrammes, des densités et des graphiques de corrélation.
Charger les données
Eh bien, d'abord les choses importantes. Nous allons charger le jeu de données Titanic dans Python pour effectuer une EDA.
#Load the required libraries
import pandas as pd
import numpy as np
import seaborn as sns

#Load the data
df = pd.read_csv('titanic.csv')


#View the data
df.head()

Nos données sont prêtes à être explorées !
1. Informations de base sur les données - EDA
La fonction df.info() nous donnera des informations de base sur l'ensemble de données. Pour toute donnée, il est bon de commencer par connaître ses informations. Voyons comment cela fonctionne avec nos données.
#Basic information

df.info()

#Describe the data

df.describe()

- Décrire les données - Statistiques descriptives.

En utilisant cette fonction, vous pouvez voir le nombre de valeurs nulles, les types de données et l'utilisation de la mémoire comme indiqué dans les sorties ci-dessus, ainsi que des statistiques descriptives.
2. Valeurs dupliquées
Vous pouvez utiliser la fonction df.duplicate.sum() pour calculer la somme des valeurs dupliquées présentes, le cas échéant. Cela montrera le nombre de valeurs dupliquées si elles sont présentes dans les données.
#Find the duplicates

df.duplicated().sum()
0
Eh bien, la fonction a renvoyé '0'. Cela signifie qu'il n'y a pas une seule valeur dupliquée présente dans notre ensemble de données et c'est très bon à savoir.
3. Valeurs uniques dans les données
Vous pouvez trouver le nombre de valeurs uniques dans une colonne particulière en utilisant la fonction unique() en python.
#unique values

df['Pclass'].unique()

df['Survived'].unique()

df['Sex'].unique()
array([3, 1, 2], dtype=int64)


array([0, 1], dtype=int64)


array(['male', 'female'], dtype=object)
La fonction unique() a retourné les valeurs uniques présentes dans les données et c'est plutôt cool !
4. Visualisez les comptes uniques
Oui, vous pouvez visualiser les valeurs uniques présentes dans les données. Pour cela, nous allons utiliser la bibliothèque seaborn. Vous devez appeler la fonction sns.countplot() et spécifier la variable pour tracer le graphique des comptes.
#Plot the unique values

sns.countplot(df['Pclass']).unique()

C'est génial ! Tu fais bien. C'est aussi simple que cela. Bien que l'EDA ait deux approches, un mélange de graphique et de non-graphique te donnera l'ensemble du tableau.
5. Trouver les valeurs nulles
Trouver les valeurs nulles est l'étape la plus importante de l'EDA. Comme je l'ai dit maintes fois, assurer la qualité des données est primordial. Voyons donc comment nous pouvons trouver les valeurs nulles.
#Find null values

df.isnull().sum()
PassengerId      0
Survived         0
Pclass           0
Name             0
Sex              0
Age            177
SibSp            0
Parch            0
Ticket           0
Fare             0
Cabin          687
Embarked         2

dtype: int64
Oh non, nous avons des valeurs nulles dans les variables ‘Âge’ et ‘Cabine’. Mais ne vous inquiétez pas. Nous allons trouver une solution pour les gérer bientôt.
6. Remplacer les valeurs nulles
Salut, nous avons une fonction replace() pour remplacer toutes les valeurs nulles par des données spécifiques. C'est vraiment bien !
#Replace null values

df.replace(np.nan,'0',inplace = True)

#Check the changes now
df.isnull().sum()
PassengerId    0
Survived       0
Pclass         0
Name           0
Sex            0
Age            0
SibSp          0
Parch          0
Ticket         0
Fare           0
Cabin          0
Embarked       0

dtype: int64
Ouah ! C'est génial. Il est très facile de trouver et de remplacer les valeurs nulles dans les données comme montré. J'ai utilisé 0 pour remplacer les valeurs nulles. Vous pouvez même opter pour des méthodes plus significatives telles que la moyenne ou la médiane.
7. Connaître les types de données
Il est très important de connaître les types de données que vous explorez, et c'est aussi un processus facile. Voyons comment cela fonctionne.
#Datatypes

df.dtypes
PassengerId      int64
Survived         int64
Pclass           int64
Name            object
Sex             object
Age             object
SibSp            int64
Parch            int64
Ticket          object
Fare           float64
Cabin           object
Embarked        object

dtype: object
C'est tout. Vous devez utiliser la fonction dtypes pour cela comme montré et vous obtiendrez les types de données de chaque attribut.
8. Filtrer les données
Oui, vous pouvez filtrer les données en fonction de certaines logiques.
#Filter data

df[df['Pclass']==1].head()

Vous pouvez voir que le code ci-dessus n'a renvoyé que des valeurs de données qui appartiennent à la classe 1.
9. Un box plot rapide
Vous pouvez créer un box plot pour n'importe quelle colonne numérique en utilisant une seule ligne de code.
#Boxplot

df[['Fare']].boxplot()

10. Graphique de corrélation - EDA
Enfin, pour trouver la corrélation entre les variables, nous pouvons utiliser la fonction de corrélation. Cela vous donnera une bonne idée de la force de la corrélation entre différentes variables.
#Correlation

df.corr()

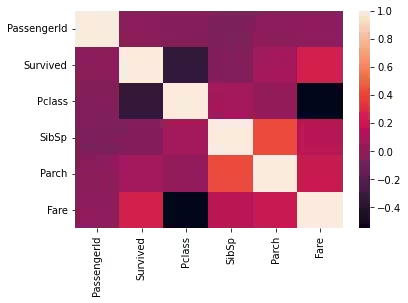
Ceci est la matrice de corrélation avec une plage de +1 à -1 où +1 est fortement et positivement corrélé et -1 sera fortement corrélé négativement.
Vous pouvez même visualiser la matrice de corrélation en utilisant la bibliothèque seaborn comme montré ci-dessous.
#Correlation plot

sns.heatmap(df.corr())
Note de fin - EDA
L'EDA est la partie la plus importante de toute analyse. Vous apprendrez beaucoup de choses sur vos données. Vous trouverez des réponses à la plupart de vos questions avec l'EDA. J'ai essayé de montrer la plupart des fonctions Python utilisées pour explorer les données avec des visualisations. J'espère que vous avez quelque chose tiré de cet article.
C'est tout pour l'instant ! Joyeux Python :)
Lire plus : Analyse exploratoire des données